
把昨天那 5 萬塊向量搬進 Chroma:加一條新規定 75 毫秒生效、重開機資料還在、能只搜某一章。然後同一組 15 題用預設參數查,命中率從 10/15 掉到 8/15——又「掉題」了:本來找得到答案的題目,換成快而近似的檢索之後,找不到了。
向量=AI 把一段文字算成的一串數字,像「語意指紋」——內容越像、指紋越近,檢索就是在比指紋(Day 8 有完整說明)。
昨天的 FAISS 索引:程式一關就沒了(下次重建 265 秒)、加一塊要打掉重練、不能按條件過濾。這三件事就是「索引」跟「資料庫」的差別。語料題目照舊:虛構的《員工工作規則》59 條、同一組 15 題。
內嵌模式,不架伺服器、不開埠:
client = chromadb.PersistentClient(path="chroma_db/",
                                   settings=Settings(anonymized_telemetry=False))
col = client.create_collection("work-rules",
                               configuration={"hnsw": {"space": "cosine"}})
col.add(ids=["art-24"], embeddings=[...], documents=[條文原文],
        metadatas=[{"article_no": 24, "chapter_no": 5}])
跟昨天的差別,一張圖:
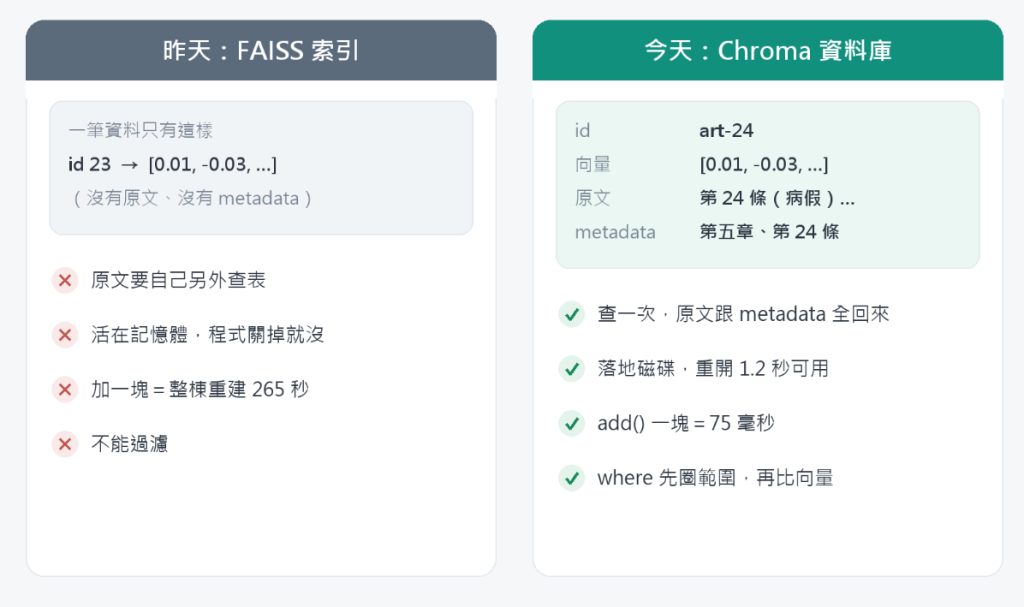
另外兩件小事:算「像不像」的方法要自己指定成 cosine(跟前幾天同一把尺);它回傳的是「距離」,越小越像(距離=1−相似度)。還有它預設開著「遙測」——在背景匿名回報使用統計給開發商,範例把它關了。
補充:Chroma 底層就是昨天的 HNSW,仍是近似檢索。
同一組 15 題、同一把尺:排第一名的結果(top-1)跟預期條文重疊才算中。新增一把尺:每題查三次——不過濾/過濾到正確章/過濾到錯誤章。偏誤先自首:Chroma 建圖是多執行緒、之後還會背景整理,掉哪幾題重跑會浮動,只能重現量級;延遲含撈原文的時間,跟昨天的純索引數字不能直接比。
15 題的第一名答案跟昨天完全相同、命中同樣 10/15。延遲有個更準的講法:59 塊查一題 3.2 毫秒,灌到 50,059 塊也才 5.1 毫秒——資料放大 848 倍,只慢 2 毫秒。代表這筆時間大多不是花在比指紋,而是把原文跟標籤從硬碟撈回來的固定開銷。這就是資料庫稅的本質:按次收固定費,幾乎不按資料量計價。
| 條件 | 命中 |
|---|---|
| 不過濾 | 10/15 |
| 過濾到正確章 | 12/15 |
| 過濾到錯誤章 | 0/15 |
過濾對了,救回的正好是 2 題「答案被別章搶走」的題——例如問「洩漏公司資料會受什麼處分」,答案在獎懲章第 47 條,第一名卻被聘僱章第 7 條搶走;只搜獎懲章,答案就回來了。但同章內的混淆一題都沒救——過濾改的是「跟誰比」,不是「比得準不準」。
過濾錯了,15 題全滅,而且不是報錯:它照樣交出「允許範圍內最像的」,分數看起來正常。這不是 bug,是向量檢索的本性——它永遠給你範圍內的第一名,範圍錯了它不會喊停。過濾條件的權力比向量大,設錯了向量再準都沒用。
灌回昨天的 5 萬筆合成資料,掃 ef_search(HNSW 找答案時手上同時保留幾個候選再決定:越大越不容易走丟,也越慢)。完整六檔位在 repo,關鍵三列:
| ef_search | 命中 | 延遲(中位數) |
|---|---|---|
| 8 | 6/15 | 2.9 ms |
| 100(預設) | 8/15 | 5.1 ms |
| 128 | 9/15 | 4.9 ms |
昨天 FAISS 開到 64 就全救回,今天掃到 128 還掉一題。兩邊的建圖參數不同:M(每個點連幾條線)昨天 32、Chroma 預設 16;ef_construction(建圖時的候選寬度)昨天 200、Chroma 預設 100。沒有逐一控制變數,但方向一致——圖蓋得比較省,走丟就更難救。麻煩的是 ef_search 隨時能調,M 這類建圖參數建完庫就改不了,要換只能整庫重建。
第一版實驗,我在同一個程式裡建完庫,接著一路把 ef_search 從 8 調到 128——六個檔位量出一模一樣的命中率跟延遲。世界上沒有這麼巧的事,一定是參數沒生效。
查下去發現:modify() 確實把新值寫進了資料庫設定(讀回來看得到新值),但剛建完索引的那個行程,記憶體裡的索引物件還抓著舊設定,查詢根本沒吃到。它不報錯、不警告,數字還長得很合理——如果六個檔位不是剛好完全相同,我就把錯的數字寫進文章了。
重開一個行程、重新載入資料庫再改,立刻生效。所以實驗腳本改成每個檔位開一個全新行程量(repo 的 ef_probe.py)。帶走兩條教訓:調完參數,用新行程驗證它真的生效;還有,「數字太整齊」本身就是 bug 的味道——真實的量測一定有雜訊。
我虛構了一條規章裡沒有的「第 60 條(寵物友善辦公)」來試增量,四步:
add() 把第 60 條寫進資料庫:75 毫秒,期間服務照跑、不用重建delete() 把它刪掉:71 毫秒,答案回到原狀昨天的 FAISS 做同一件事只有一種辦法:整個索引砍掉重建,265 秒。
持久化那邊:程式關掉再開,5 萬塊的庫開庫 1.2 秒、查完第一題再 9 毫秒(不含 Python 本身的啟動時間)——資料都在,不用重算。首次建庫 72 秒、磁碟 370 MB。
| 情境 | 建議 | 代價 |
|---|---|---|
| 語料固定、萬級以下 | FAISS Flat(精確全掃)/numpy 就好 | 每次啟動重建 |
| 語料會長、要過濾、要持久化 | 向量資料庫(Chroma 起步夠用) | 延遲、磁碟、預設參數自己驗 |
| 有部門/權限邊界 | metadata 過濾;where 由後端依登入者身分產生,不收前端傳值 | 設錯=全滅且看不出來 |
| 上線前 | 拿自己的資料掃 ef_search,順便挑好 M | M 改不了,換值=重建 |
新增 2 筆 embedding 共 205 tokens ≈ 新台幣 0.00013 元,其餘全命中昨天帶來的快取;5 萬個合成向量 0 元。
向量資料庫賣你的不是準確率,是營運能力:能過濾、隨加隨刪、重開機還在。準確率它反而先扣走兩題——要自己量、自己調參贖回來,而其中一顆參數(M)在建庫那一刻就焊死了。
你用的向量庫,M 是多少?是你挑的,還是預設值替你挑的?
明天 Day 12:【向量資料庫大亂鬥】
GitHub:https://github.com/wp900622/TrustRAG (day11_chroma/,clone 後 python build_db.py 即可重現)
Chroma 官方文件:https://docs.trychroma.com/
CVE-2026-45829:https://github.com/advisories/GHSA-f4j7-r4q5-qw2c
HNSW 原始論文:Malkov & Yashunin (2016)


 iThome鐵人賽
 看影片追技術